Agent Harness 从零手写:运行循环、工具调用到 MCP 与记忆
本文速览
- 项目:moqian-agent-harness(MIT 开源)
- 定位:一个从零手写 Agent Harness(大模型 Agent 运行循环)的学习项目,不依赖任何 Agent 框架
- 适合谁读:会用 API 调大模型、但说不清 Agent 内部到底怎么转的后端开发者
- 前置知识:Python 基础、了解
messages与 HTTP 接口调用即可 - 难度:⭐⭐⭐⭐ | 阅读时长:约 15 分钟 | 技术栈:Python + OpenAI 兼容接口 + 本地 Ollama(仅 RAG 相关阶段)
Agent 这个词被用得很泛。会调工具的、会规划的、能记住你的,都叫 Agent。但如果你问一句"它内部到底怎么转起来的",框架会把这个答案藏起来 —— 因为框架帮你把运行循环、工具分发、上下文管理都封好了。
所以我换个思路:不用框架,自己把每块零件写一遍。这个项目一共 29 个阶段,每个阶段一个可运行脚本加一份文档,git log 就是学习时间线。这篇不逐个复述阶段,只讲其中真正有价值的部分。
一、为什么要手写一遍,而不是直接用框架
1.1 框架把心脏藏起来了
用 LangChain 之类的框架,五行代码就能跑起一个 Agent。但一旦出问题,你会发现自己不知道从哪查起:工具为什么没被调用?上下文为什么丢了?模型为什么在同一个工具上反复打转?
手写一遍之后,这些问题的答案变得具体 —— 因为循环是你自己写的,你能一眼看出它停在哪一步。
1.2 项目的三条设计约定
- 每阶段一个可运行脚本:25 个脚本,每个 40~225 行,都能单独
python xxx.py跑起来 - 每阶段一份文档:
stage/00到stage/29,写清这一阶段学什么、验收标准是什么 - 不追求一次性做对:很多阶段是"发现上一阶段的缺陷,再修它",比如 Stage 26 就是嫌 Stage 21 的执行者不会调工具,才把 Executor 换成 ReAct
第三条是这套设计最有意思的地方:它保留了一个真实开发者的演进路径,而不是把最终答案直接摆出来。
1.3 能力演进路线图
二、Agent 的心脏:运行循环
2.1 核心不到 20 行
Agent 和"聊天机器人"的分界线就是这段循环。去掉打印和边界处理,它的骨架就这么点:
MAX_STEPS = 5  # 最多循环几步,防止模型一直调工具死循环

for step in range(MAX_STEPS):
    response = client.chat.completions.create(
        model=MODEL,            # 脚本顶部统一配置,换模型只改这一行
        messages=messages,
        tools=tools,
    )
    msg = response.choices[0].message

    if msg.tool_calls:
        # 把模型这条回复回填进历史(tool_calls 也要带上,否则下一轮对不上)
        messages.append({"role": "assistant", "content": msg.content,
                         "tool_calls": [...]})
        # 执行它要调的每个工具,把结果以 role="tool" 回传
        for tc in msg.tool_calls:
            messages.append({"role": "tool", "tool_call_id": tc.id,
                             "content": TOOL_MAP[tc.function.name]()})
        continue                # 回到循环顶部,让模型看到工具结果

    # 没有 tool_calls = 模型给出最终答案
    messages.append({"role": "assistant", "content": msg.content})
break"发请求 → 看它要不要调工具 → 执行工具并回传 → 再发请求" —— 这就是运行循环(Run Loop)。整个 Agent 体系里所有复杂的东西,都是往这个骨架上挂零件。
2.2 三个必踩的坑
| 坑 | 现象 | 正确做法 |
|---|---|---|
tool_calls 没回填历史 | 下一轮请求报错,或模型反复调同一个工具 | assistant 那条消息必须连 tool_calls 一起 append |
tool_call_id 没配对 | 服务端报参数校验错误 | 工具结果必须用同一个 tc.id 作为 tool_call_id |
| 没有步数上限 | 模型陷入循环,程序卡死还一直烧 token | MAX_STEPS 强制中断并在超限时给出提示 |
⚠️ 踩坑:这三个坑只要踩过一遍,以后看任何 Agent 框架的源码都会觉得眼熟 —— 它们干的就是同一件事。
2.3 一次工具往返的全貌
注意模型从头到尾没有执行任何代码,它只是"点了菜";真正动手的是循环里的 TOOL_MAP。这个认知很关键 —— 它意味着工具的安全边界必须由你(服务端)来守,不能指望模型自律。第七节会回到这一点。
三、工具系统与健壮性
3.1 从声明到分发
工具系统只有三个部件,Stage 4 把它们讲得很干净:
tools声明:告诉模型有哪些工具、每个工具要什么参数(JSON Schema)TOOL_MAP分发表:工具名到实际函数的映射,加工具就往这里加一行- 参数解析:模型传回的是 JSON 字符串,得解析成 Python 参数再调用
这套"声明 — 分发 — 解析"的结构,就是后面 MCP 要标准化的对象。先手写一遍,才知道 MCP 到底在解决什么问题。
3.2 让错误变成对话的一部分
新手最容易写错的健壮性处理是"工具报错就抛异常"。正确做法是把异常也当成工具结果回传:
try:
    result = TOOL_MAP[name](**args)
except Exception as e:
result = f"工具执行失败:{e}" # 让模型看见错误,它自己会换个思路这样模型能读到"失败了、原因是什么",进而换个工具或换个参数重试 —— 而不是整个程序崩掉。
💡 经验:错误从"异常"变成了"上下文",这是 Agent 健壮性的核心思路。
同类的还有两个工程细节,都在项目里踩过:模型偶尔返回空内容,所以要重试;工具可能耗时很久,所以要超时。
3.3 流式与结构化输出,各解决什么
- 流式(Stage 6):解决"等得难受"。边生成边显示,体验完全不同
- 结构化输出(Stage 7):解决"程序读不懂"。让模型返回 JSON,程序才能消费 —— 这是 Agent 之间、Agent 与业务系统之间对接的前提
- 上下文管理(Stage 8):解决"记不下了"。messages 只增不减,一定会撞上上下文上限,所以需要截断或摘要压缩
四、MCP:把"手写工具"换成"运行时发现"
4.1 手写 TOOL_MAP 的天花板
手写工具在单机 demo 里没问题,一放到真实场景就露馅:
- 每接一个新工具,就要改
tools声明、改TOOL_MAP、改参数解析 - 工具和 Agent 代码强耦合,换个工具集就得改代码
- 别人写好的工具,你没法直接拿来用
MCP(Model Context Protocol)解决的正是这件事:把"工具怎么暴露、怎么发现、怎么调用"标准化。
4.2 server / client / stdio 三件事
list_tools() 是这套机制的灵魂 —— 客户端不再写死工具清单,而是运行时问出来:
async with stdio_client(server) as (read, write):
    async with ClientSession(read, write) as session:
        await session.initialize()
        tools = await session.list_tools()          # 发现:运行时问出有哪些工具
r = await session.call_tool("add", {"a": 3, "b": 5}) # 调用:工具名 + JSON 参数4.3 桥接只有一行
MCP 和 OpenAI function calling 之间要对接,看起来是个麻烦事,实际上一行就够:
def mcp_tool_to_openai(tool):
    """把 MCP 工具转成 OpenAI function 格式"""
    return {
        "type": "function",
        "function": {
            "name": tool.name,
            "description": tool.description or "",
            "parameters": tool.input_schema,   # MCP 给的就是 JSON Schema,直接当 parameters 用
        },
}因为两边都用 JSON Schema 描述参数,所以 input_schema 可以原样当 parameters 用。这一行是整个 MCP 集成里最漂亮的地方。
4.4 换 server 就换能力
写完之后的效果:换一个 MCP 服务器,Agent 代码一行都不用改,它会自己发现新工具。这跟手写 TOOL_MAP 的时代是完全不同的体验 —— 也是"标准化"这件事真正的价值。
项目里 Stage 27 更进一步:把规划器(Planner)的执行者从"手写工具"换成"MCP 工具",能力变了,规划逻辑没动。
五、两层循环:Plan-and-Execute + ReAct
5.1 单层循环在复杂任务上会散
一个循环处理"查资料 → 算数 → 写报告"这种多步任务时,模型容易顾此失彼:做着第三步忘了第一步的目标。
解法是把循环分成两层:
5.2 外层拆步骤,内层动手
- 外层(Plan-and-Execute):Planner 先把任务拆成 3~5 个清晰步骤,只输出 JSON
- 内层(ReAct):每一步交给一个会调工具的循环去完成
- 最后:Summarizer 把各步成果组织成完整回答
这个项目在 Stage 26 专门做了一次演进:Stage 21 的执行者只是个"纯 LLM 角色",在脑子里把步骤完成,算错了也将错就错;Stage 26 把它换成 ReAct 循环之后,执行者能真的去查时间、真的去算数,闭环才完整。
5.3 顺带解决的两个工程问题
写规划器时会撞上两个很典型的坑,项目的处理方式可以直接抄:
# 1) 模型可能不老实:把 JSON 包在 markdown 代码块里,或前后加一堆解释
def extract_steps(text):
    text = text.strip()
    if text.startswith("```"):           # 剥掉代码围栏
        text = text.split("```", 2)[1]
        if text.startswith("json"):
            text = text[4:]
    start = text.find("{")               # 从第一个 { 开始解析,忽略前面的话
    obj, _ = json.JSONDecoder().raw_decode(text[start:])
    return obj["steps"]

# 2) 模型偶尔返回空内容 —— 空就重试,别直接崩
for _ in range(3):
    resp = client.chat.completions.create(**kwargs)
    content = resp.choices[0].message.content
    if content and content.strip():
        return content
return ""另外,工具实现里也有安全细节:calculate 工具不允许直接把表达式喂给 eval,而是先用白名单正则过滤掉除数字和运算符之外的一切字符。
六、记忆与技能:让能力可积累、可打包
6.1 短时记忆 vs 长期记忆
多轮对话阶段的结论是"模型没记忆,messages 就是记忆"——但那是短时记忆,程序一关就全忘了。长期记忆需要三个动作:
有意思的是 recall 用的是 RAG 阶段那套 embedding + 余弦相似度 —— 同一套机制,上次检索的是文档片段,这次检索的是记忆条目。理解到这一层,就会发现 embedding 是个通用工具,不只是给 RAG 用的。
remember 里还有个小设计值得注意:存之前先算一遍相似度,如果已经有几乎一样的记忆(相似度 > 0.9)就跳过,避免同一件事反复记。
6.2 记忆做成工具
Stage 22 的记忆是程序自动调用的。到 Stage 28 换了个思路:把 save_memory / recall_memory 做成两个工具,让模型自己决定什么时候该记、什么时候该查。同时把暴力余弦换成了 FAISS 向量库。
这一步的差别很像"自动保存"和"手动保存":前者不会漏,但会存一堆没用的;后者更聪明,但要靠模型判断。
6.3 Skill:把"一类任务怎么做"打包
技能(Skill)解决的是"能力复用":把"一类任务怎么做"打包成自包含的包,需要时再加载。项目里 skills/ 下有六个技能 —— 代码审查、写作助手、数学老师、画图、翻译、计算器。
机制本身很朴素:启动时扫描目录建注册表,让模型按任务挑一个技能,把它的指令装进 system prompt。
真正的亮点在 Stage 29:技能不只有指令,还能带工具。skills/画图/ 和 skills/计算器/ 目录里除了 SKILL.md,还有一个 tool.py 暴露自己的工具集;技能被选中时,工具一起注册进运行循环。到这一步,一个"能力包"才算完整 —— 指令加工具,可以整体搬走。
七、能给别人用之前:沙箱与评测
7.1 三条原则
项目把 Agent 安全浓缩成三句话:
- 最小权限:只给完成任务所需的最小能力
- 白名单:只允许明确许可的操作,而不是罗列禁止项
- 隔离:把不可信代码关进受限环境里跑
第 2 条的补充说明很关键:列黑名单永远列不全,所以方向应该反过来 —— 默认拒绝,明确许可才放行。
7.2 纵深防御:模型拒绝了,不等于你可以不写护栏
这是我在这个项目里最有共鸣的一句话:"模型拒绝了"不等于"你可以不写 server 黑名单"。
⚠️ 别省护栏:模型是不可信的输入源 —— 它今天拒绝执行
format c:,不代表明天换了 prompt、换了模型、被注入了恶意文本之后还会拒绝。所以护栏必须一层层独立设置。
每层都假设上一层已经失守 —— 这就是纵深防御。项目里有个演示很直观:绕过模型直接调 run_command("format c:"),server 侧的黑名单照样把它拦下来。
轻量沙箱的最小实现也就几行:
# 模型生成的代码不可信,丢进受限子进程跑
subprocess.run(
    [sys.executable, "-c", bad_code],
    capture_output=True, text=True,
    timeout=2,                 # 死循环 / 挂起一律掐断
)真正的沙箱还要更狠:容器隔离、禁用网络、只读文件系统。但先有超时和白名单,就已经挡掉大部分事故了。
7.3 评测三件套
没有评测的 Agent 只能靠"感觉还行"。项目的做法是三层:
| 层次 | 做法 | 作用 |
|---|---|---|
| 测试集 | 一组(问题 + 标准答案) | 提供统一的"标尺" |
| 语义打分 | 比生成答案与标准答案的向量相似度 | 容忍措辞差异,不要求逐字一致 |
| LLM 裁判 | 让另一个模型按标准答案判对错 | 处理需要理解语义才能判断的情况 |
三个一起用,才能回答"改了 prompt 之后到底变好了还是变差了"。
八、做成产品与小结
8.1 从脚本到服务
前面所有能力最终收在一个 FastAPI 服务里,配一个单页前端。这个界面本身就是"知识库问答 Agent"的落地形态 —— 检索的语料正是项目自己的 stage/ 文档,所以它回答的就是"这个项目里的概念":
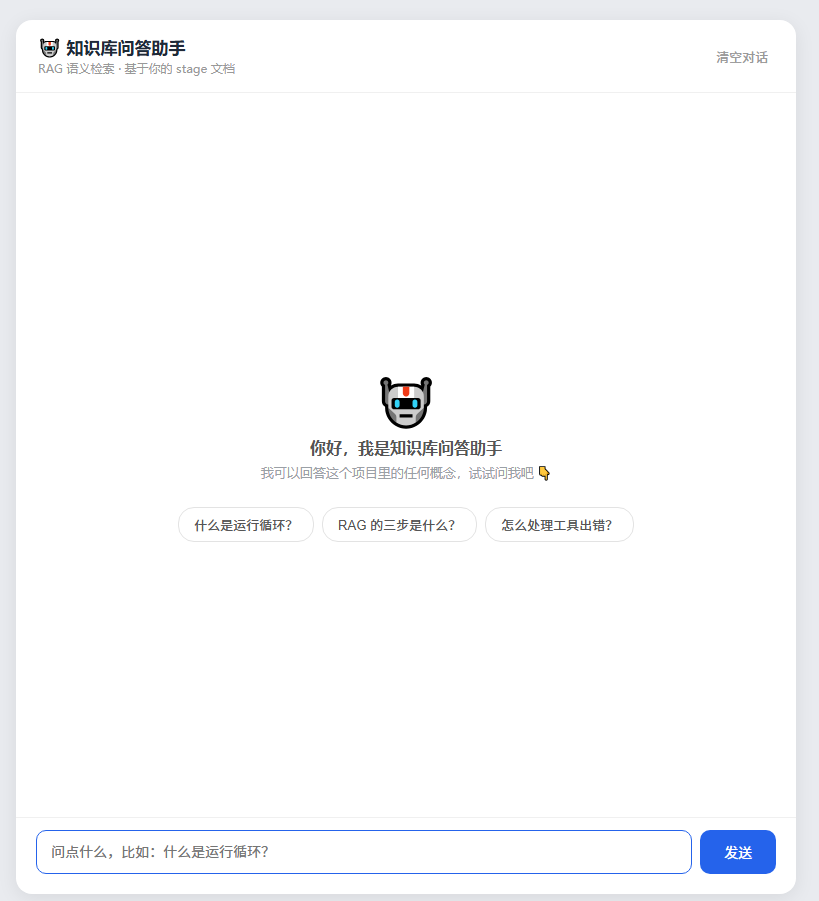
界面副标题写着"RAG 语义检索 · 基于你的 stage 文档",示例问题正是「什么是运行循环?」「RAG 的三步是什么?」「怎么处理工具出错?」—— 文档写完之后,Harness 自己成了这套文档的入口。这是我做完整个项目后觉得最有意思的一个副产品。
8.2 29 个阶段怎么走:六条学习线
不建议从 1 顺着做到 29,而是按学习线走,每条线都能单独成篇:
| 学习线 | 路径 |
|---|---|
| 入门主线 | hello.py → chat.py → loop.py → agent.py |
| RAG 线 | rag.py → vector_rag.py → semantic_rag.py → kb_agent.py |
| MCP 线 | mcp_server.py / mcp_client.py → mcp_agent.py → planner_mcp.py |
| Agent 模式线 | reflect.py(反思)→ planner.py(规划)→ planner_react.py(ReAct 执行) |
| 记忆线 | memory.py → memory_tool.py |
| 技能线 | skill.py → skill_tool.py |
每个脚本顶部的 docstring 都写明了这一阶段学什么,配合 stage/ 下的同名文档就是一份完整的预习与复习材料。
8.3 小结
手写一遍之后,我对 Agent 的理解变成了这几句:
- 心脏就是一个循环 —— 发请求、执行工具、回传结果、再发请求,没有更多魔法
- 工具的安全边界在自己这边 —— 模型只负责"点菜",护栏必须由服务端独立设置
- 标准化带来解耦 —— MCP 那一行
input_schema转parameters,背后是"工具与 Agent 彻底解耦"的价值 - 演进比一步到位更真实 —— 项目里每一次重构(Executor 换成 ReAct、手写工具换成 MCP)都是发现上一阶段的缺陷之后才做的
项目已开源(MIT):https://github.com/zhaoxuejie/moqian-agent-harness
安全提醒:项目里的命令执行、文件读写工具都配了沙箱护栏,但它仍然是学习用途的代码。请始终在自己的机器、可控的目录里运行,不要把未经验证的 Agent 暴露到公网。