开源工具评测:VideoCaptioner 一条命令搞定视频字幕识别、翻译与烧录
做视频的人都知道,字幕是个体力活:
- 一段 10 分钟的口播视频,自己对着波形逐句打轴要两三个小时
- 想加英文字幕出海,翻译完还得再对齐时间轴
- Whisper 转出来的字幕一整句挂在屏幕上,根本没法读
- 剪映的自动字幕导出要开会员,还带水印
传统流程是:Whisper 出 SRT → 手动断句 → 复制到翻译软件 → 重新对齐 → 再导入剪辑软件烧录,五步下来半天就没了。
今天要聊的 VideoCaptioner(卡卡字幕助手)就是来把这条链路压缩成一条命令的——语音识别、智能断句、LLM 翻译、字幕烧录全流程自动化,免费引擎开箱即用,不用配任何 API Key。
一、项目是什么
VideoCaptioner 是作者 Weifeng(GitHub: WEIFENG2333)从 2024 年 10 月开始维护的开源项目,目前在 GitHub 上收获了 16.2k Star、1.4k Fork,采用 GPL-3.0 开源协议。它的定位很明确:基于大语言模型的视频字幕处理工具,把语音识别、字幕优化、翻译、视频合成串成一条流水线。
| 项目信息 | 详情 |
|---|---|
| 仓库地址 | github.com/WEIFENG2333/VideoCaptioner |
| 开发语言 | Python(3.10–3.12) |
| 开源协议 | GPL-3.0 |
| GitHub Star | 16.2k+ |
| 最新版本 | v1.4.2(2026-05) |
| 安装方式 | pip install videocaptioner |
| 运行形态 | CLI + GUI 桌面版 |
| 免费引擎 | 必剪识别、必应翻译、谷歌翻译(零配置) |
它的工作原理是一条标准化流水线:
音视频输入 → 语音识别 → 字幕断句 → LLM 优化 → 翻译 → 视频合成每一步都可以单独调用,也可以一条 process 命令跑完。核心差异化在于:识别用本地 Whisper 保证隐私,断句和翻译用 LLM 保证可读性,免费引擎不花钱也能出活。
二、为什么推荐它
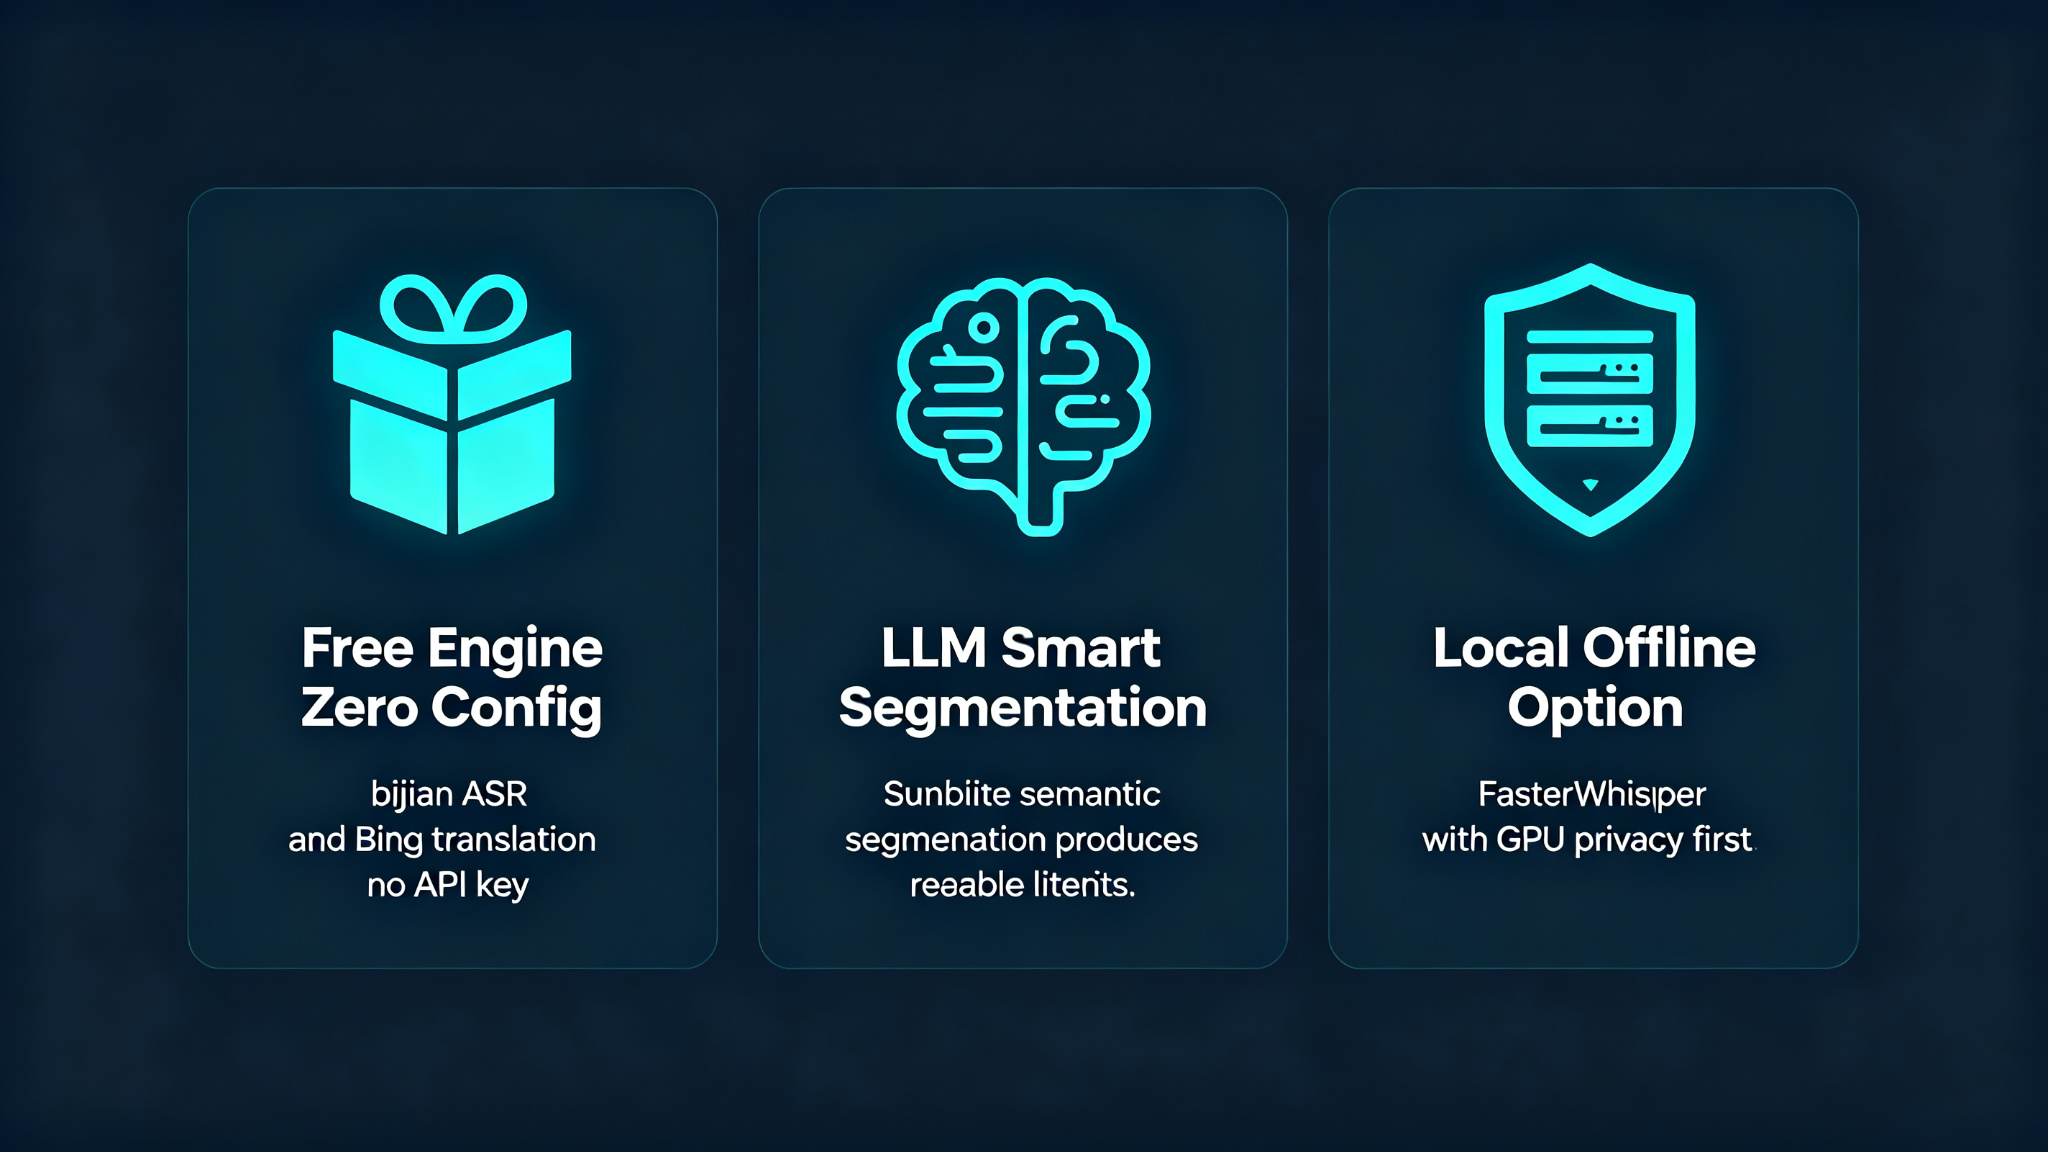
1. 免费引擎零配置开箱即用
这是它最实在的一点。pip install 完直接就能用——识别走必剪(在线免费接口),翻译走必应或谷歌,不需要你申请任何 API Key、不需要下载几个 G 的模型文件。想试一下效果,一条命令就能出结果,这对新手非常友好。等你觉得免费引擎不够用了,再配 LLM API Key 升级精度。
2. LLM 断句解决 Whisper 字幕最难看的问题
用过 Whisper 的人都知道,它转出来的字幕经常是一大坨一句话撑满整个屏幕,或者断在奇怪的位置。VideoCaptioner 用 LLM 做语义级别的断句和标点恢复,输出的 SRT 是按阅读节奏切分的,不是按声学停顿切分的。这一步看似不起眼,但直接决定了字幕能不能直接发布。
3. 本地离线识别,隐私不出机器
视频作者最担心的就是把没发布的作品上传到第三方服务。VideoCaptioner 支持 FasterWhisper 本地模型,99 种语言,支持 GPU 加速。你的视频从头到尾在自己机器上跑,不上传任何音频到云端。对于商业项目和敏感内容,这是硬需求。
4. CLI + GUI 双形态,脚本友好
它既有图形界面(给不想碰命令行的人),也有完整的 CLI(给要批量处理的人)。更妙的是它还提供 Claude Code Skill,AI 编程助手可以直接调用它处理视频。这种"既能手动点、也能脚本跑"的设计,是专业工具该有的样子。
三、同类工具对比
| 对比维度 | VideoCaptioner | 剪映自动字幕 | Whisper(裸跑) | 商业字幕 SaaS |
|---|---|---|---|---|
| 识别精度 | FasterWhisper/必剪可选 | 剪映自有引擎 | Whisper 本地 | 云端 ASR |
| 断句质量 | LLM 语义断句 | 自动断句 | ❌ 一整句 | 自动断句 |
| 翻译 | LLM/必应/谷歌,多引擎 | 内置翻译 | ❌ 需自己接 | 内置翻译 |
| 字幕烧录 | ✅ ASS 样式,软/硬字幕 | ✅ | ❌ | ✅ |
| 批量处理 | ✅ CLI 脚本 | ❌ 手动逐条 | ✅ | 部分支持 |
| 隐私 | 本地模型可选 | 上传云端 | 完全本地 | 上传云端 |
| 费用 | 免费(开源) | 会员功能 | 免费 | 按分钟收费 |
| 配音/对口型 | ✅ dub 命令 | 部分支持 | ❌ | 部分支持 |
它的差异化亮点:
- 免费引擎不花钱也能出活——必剪识别 + 必应翻译零配置
- LLM 断句直接可读——不用手动再修时间轴
- 一条命令跑完整个流水线——识别到烧录不用切软件
- 本地 GPU 可选——商业内容不上云
- CLI 可脚本化——批量处理几十条视频不费劲
四、手把手实操教程
环境准备
- Python:3.10–3.12(不支持 3.13)
- ffmpeg:视频合成和字幕烧录需要
- GPU(可选):用 FasterWhisper 本地模型时,有 NVIDIA 显卡会快很多
- LLM API Key(可选):只用免费引擎可以不配
第一步:安装
pip install videocaptioner装完同时有 CLI 和 GUI。验证一下:
videocaptioner --help第二步:免费识别(零配置)
用必剪引擎直接转录,不需要任何 Key:
videocaptioner transcribe video.mp4 --asr bijian会输出一个 SRT 文件。如果你想用本地 Whisper(隐私优先):
videocaptioner transcribe video.mp4 --asr faster-whisper --model small第一次跑会自动下载模型,之后就是纯本地。
第三步:字幕翻译
对已有的 SRT 做翻译,免费走必应:
videocaptioner subtitle input.srt --translator bing --target-language en想用 LLM 翻译(质量更高,需要先配 Key):
videocaptioner config set llm.api_key <your-key>
videocaptioner config set llm.api_base https://api.deepseek.com/v1
videocaptioner config set llm.model deepseek-chat

videocaptioner subtitle input.srt --translator llm --target-language ja第四步:全流程一条龙
从视频直接到烧录好字幕的成片,一条命令:
videocaptioner process video.mp4 --target-language en它会自动完成:识别 → 断句优化 → 翻译 → 字幕烧录。
第五步:字幕烧录到视频
如果你已经有 SRT,只想把字幕压到画面上:
videocaptioner synthesize video.mp4 -s subtitle.srt第六步:其他实用命令
# 从 YouTube/B站下载视频
videocaptioner download "https://youtube.com/watch?v=xxx"

# 根据字幕生成配音(多语言配音视频)
videocaptioner dub video.mp4 -s subtitle.srt

# 打开图形界面
videocaptioner-gui

# 查看当前配置
videocaptioner config show常用参数速查表
| 命令 | 作用 |
|---|---|
transcribe | 语音转字幕 |
subtitle | 字幕优化/翻译 |
process | 全流程(识别→优化→翻译→合成) |
synthesize | 字幕烧录到视频 |
dub | 生成配音音轨/视频 |
download | 下载在线视频 |
config | 配置管理 |
--asr | 指定识别引擎(faster-whisper/bijian/jianying/whisper-api) |
--translator | 指定翻译引擎(llm/bing/google) |
--target-language | 目标语言(en/ja/ko 等) |
五、适用场景
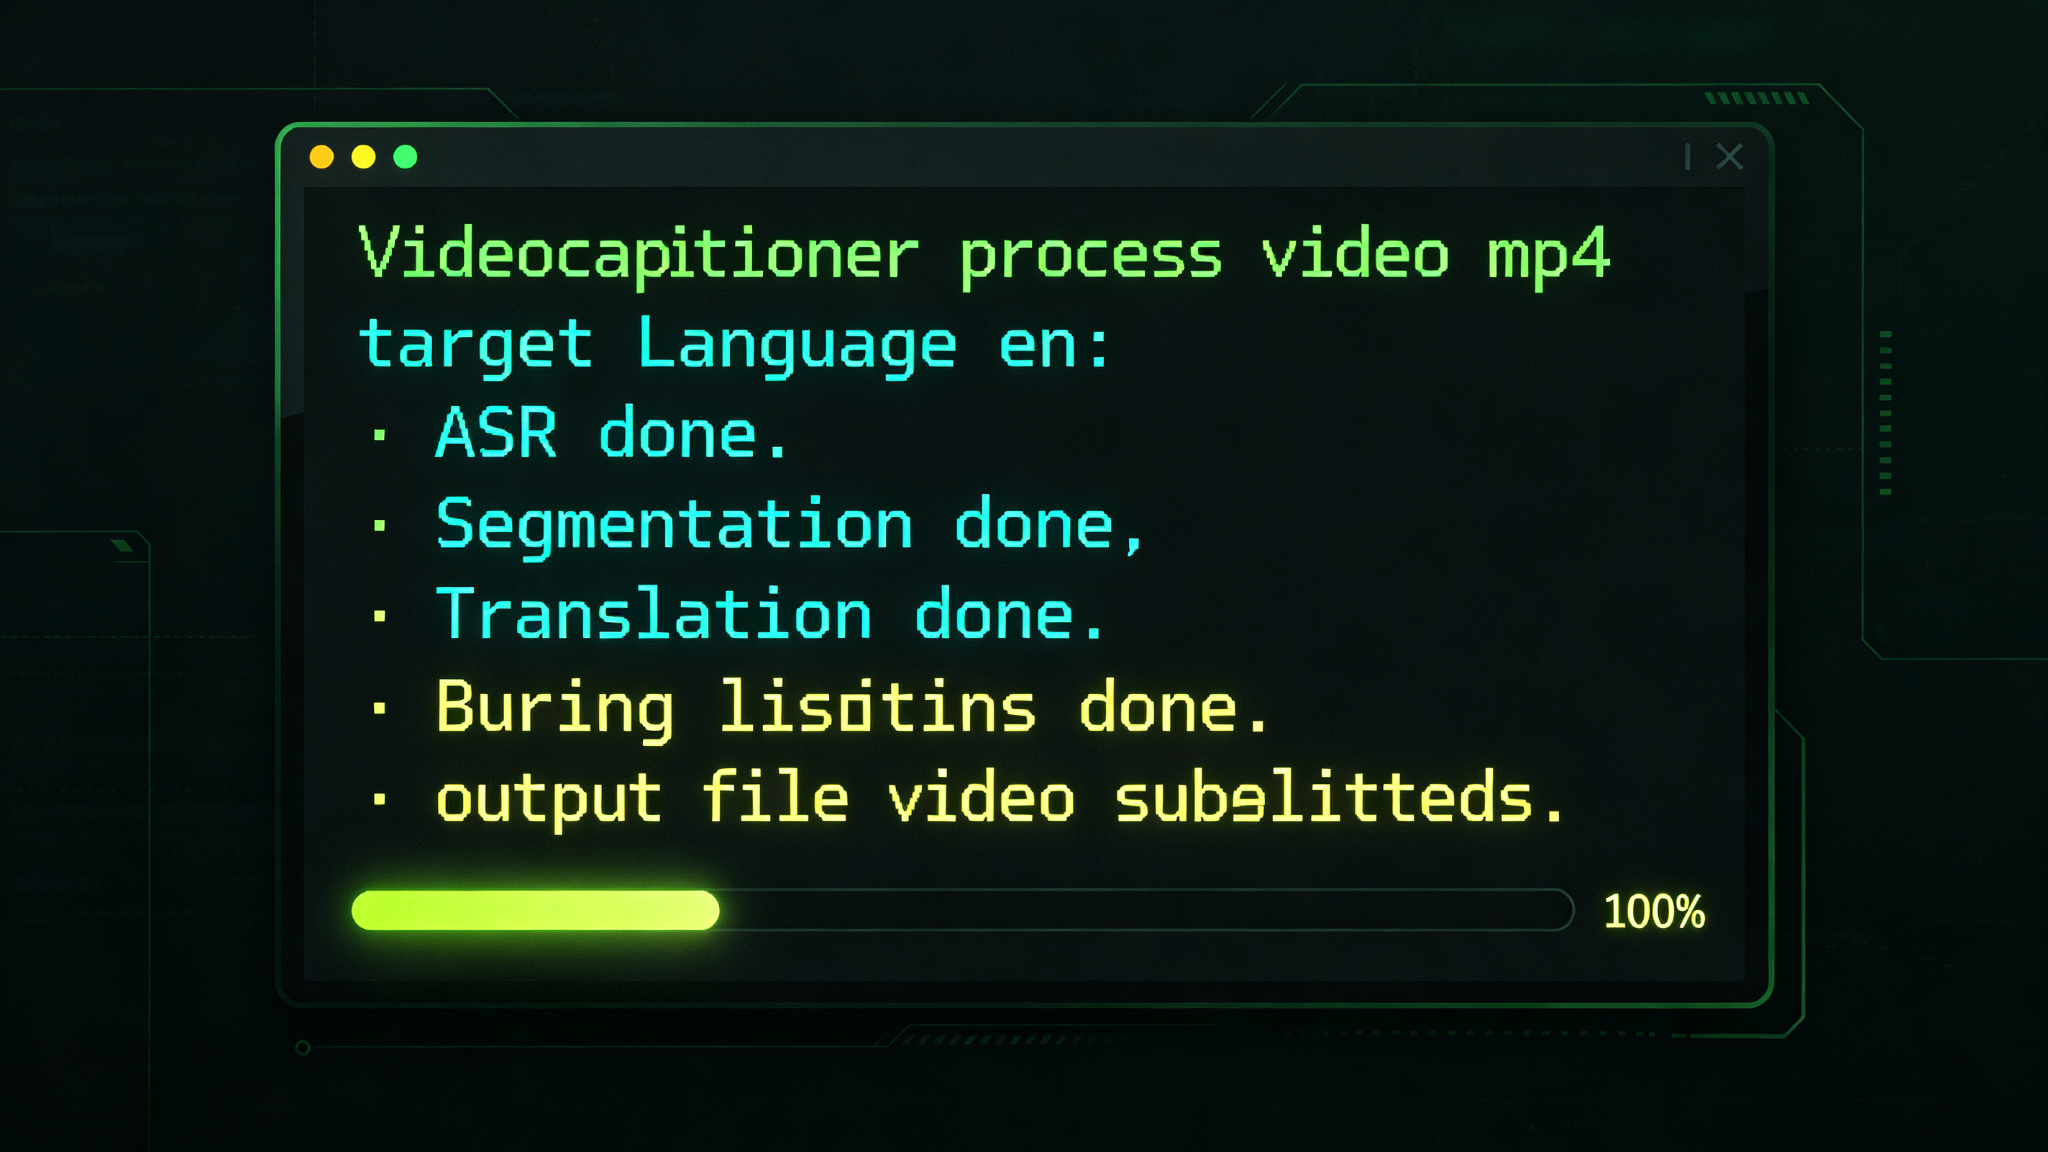
场景一:知识博主批量出海。做中文口播视频的 UP 主,想把内容翻译成英文发到 YouTube。以前要找翻译、调轴、烧录,现在一条 process --target-language en 出成片,LLM 还能帮忙把口语化的中文翻成自然的英文。
场景二:播客/讲座视频归档。一堆会议录像、访谈录音需要出文字稿。用 FasterWhisper 本地跑,隐私不出机器,LLM 断句后直接生成可读的字幕文件,比人工整理快几十倍。
场景三:短视频团队提效。抖音/快手批量出片,字幕是刚需。CLI 脚本化后,把素材丢进文件夹,脚本自动跑完识别翻译烧录,一天出几十条片子不靠手点。
场景四:Claude Code 自动化工作流。它提供了 Claude Code Skill,你可以跟 AI 说"把这个视频加上双语字幕",AI 直接调用 VideoCaptioner 完成,不需要你手动敲命令。
六、客观优劣总结
优势:
- 免费引擎零配置——必剪识别 + 必应翻译,装完就能用
- LLM 断句直接可读——解决 Whisper 输出最难看的痛点
- 全流程一条龙——识别到烧录不用切软件
- 本地离线可选——FasterWhisper + GPU,商业内容不上云
- CLI/GUI 双形态——手动和脚本都能用
- GPL-3.0 开源——免费,可二次开发
- 活跃维护——2024 年 10 月启动,持续迭代到 v1.4.2
局限性:
- Python 依赖链——
pip install比单文件二进制重,需要管理 Python 版本 - 免费引擎依赖在线接口——必剪/必应是调用第三方免费接口,稳定性和并发不如付费 API
- GPL-3.0 协议——商用闭源产品集成时要注意传染条款
- FasterWhisper 模型要下载——本地识别第一次需要下模型(small 几百 MB,large 几个 G)
- GPU 配置有门槛——想用 GPU 加速需要装 CUDA 环境,对新手不友好
- 字幕样式有限——ASS 样式可定制但不如专业剪辑软件精细
- 复杂时间轴调整仍需手动——断句已经帮你做好了,但偶尔需要在 Aegisub 里微调
合规提醒:请仅对自己拥有版权或已获授权的视频使用本工具。不要用于未经授权的内容转写、翻译或分发。处理敏感商业内容时,优先使用本地 FasterWhisper 模式,不要上传到在线接口。
七、写在最后
如果你做视频还在手工打轴、或者在剪映里开会员导出字幕,VideoCaptioner 值得试一下。它不会替代专业字幕师的精修,但能把 80% 的粗活——识别、断句、翻译、烧录——自动化掉,剩下 20% 的精修才是你真正该花时间的地方。
# 30 秒上手
pip install videocaptioner
videocaptioner process video.mp4 --target-language en仓库地址:github.com/WEIFENG2333/VideoCaptioner,觉得有用记得去给作者点个 Star。